Innhold i denne artikkelen
Jeg får jevnlig henvendelser fra nye kunder som vil "bli synlig i KI", ikke som et forslag til diskusjon, men som en bestilling.
Det ironiske er at bestillingen som regel finnes fordi et KI-verktøy skrev briefen for dem i utgangspunktet.
Når jeg spør om de faktisk vet hva en LLM er, altså verktøyet som skrev briefen deres, eller hvordan generativt søk fungerer i praksis, møter jeg som regel tomme blikk.
Det er ikke deres feil. Landskapet har blitt komplisert veldig fort, og de fleste forklaringene som finnes der ute er enten for tekniske eller for forenklede. Så her er mitt forsøk på midten.
Det er også en del av grunnen til at jeg skriver denne artikkelen, og de som følger etter. Som organisk synlighetsspesialist er det rett og slett jobben min å forstå de nye frontene for søk, ikke bare den jeg lærte meg for ti år siden.
Denne serien er like mye min egen læringsprosess som noe annet, og jeg deler den underveis i stedet for å vente til jeg føler meg helt ferdig utlært, for det tror jeg ingen av oss blir med det første.
Kort sagt: en søkemotor og en LLM gjør ikke det samme
En søkemotor som Google henter og rangerer sider som allerede finnes. Den genererer ingenting selv, den peker deg til svaret.
En LLM, som ChatGPT eller Claude, er trent på enorme mengder tekst for å forutsi og generere naturlig språk. Den lagrer ikke fakta i en database. Den har lært mønstre, og gjetter det mest sannsynlige svaret basert på det den er trent på.
Det betyr at en LLM alene ofte ikke vet hva som skjedde i går. For å svare på noe aktuelt må den søke, akkurat som du ville gjort, og hente inn informasjon utenfra før den formulerer et svar.
Dette høres kanskje opplagt ut når man leser det. Men det var ny informasjon for absolutt alle i rommet den dagen.
Google vinner fortsatt. Men ikke alene lenger
Jeg har vist samme type diagram i presentasjoner i årevis. Google dominerer søk med rundt 95 prosent, mens Bing, Yahoo og DuckDuckGo deler resten.
Det er fortsatt sant. Men det er ikke lenger hele historien.
Ser man på alle digitale søk, ikke bare søkemotorer, går rundt 57 prosent fortsatt gjennom Google. Men 17,9 prosent går nå til ChatGPT, opp fra nesten null for tre år siden.
Det er det største skiftet i søkevaner på svært lang tid.
Og innad i selve KI-kategorien skjer det enda mer. På bare ett år har ChatGPTs andel av chatbot-trafikk falt fra 86,7 til 51,3 prosent, mens Googles Gemini har gått fra 5,7 til 27,7 prosent. Gapet mellom dem er nesten halvert på tolv måneder.
Så her er det første poenget mitt: «hvem vinner» avhenger helt av hvilket spørsmål du stiller. Og de fleste stiller feil spørsmål.
Norge ser annerledes ut enn resten av verden
Her blir det ekstra interessant for oss som jobber med norske kunder.
I Norge er ChatGPT enda mer dominerende enn globalt. Slik fordeler mobil AI-chatbot-trafikk til norske nettsider seg:
Det egentlig interessante spørsmålet: hvordan velger en KI-modell kilde?
Vi vet nå at mange KI-modeller søker på nettet for å svare på aktuelle spørsmål. Men hvordan velger de hvilke kilder de stoler på?
Intuisjonen mange har, inkludert meg selv for ikke så lenge siden, er at modellen bare tar Googles topp ti og velger blant dem. En slags dobbel rangering, der Google rangerer først og KI-en rangerer på nytt blant det Google finner.
Det stemte mye bedre for et år siden enn det gjør i dag.
Ahrefs og BrightEdge lander på litt ulike tall, og Ahrefs selv påpeker at noe av fallet skyldes forbedret målemetodikk hos dem, ikke bare endret oppførsel hos Google.
Uansett hvilket tall man velger å stole mest på, peker alle i samme retning.
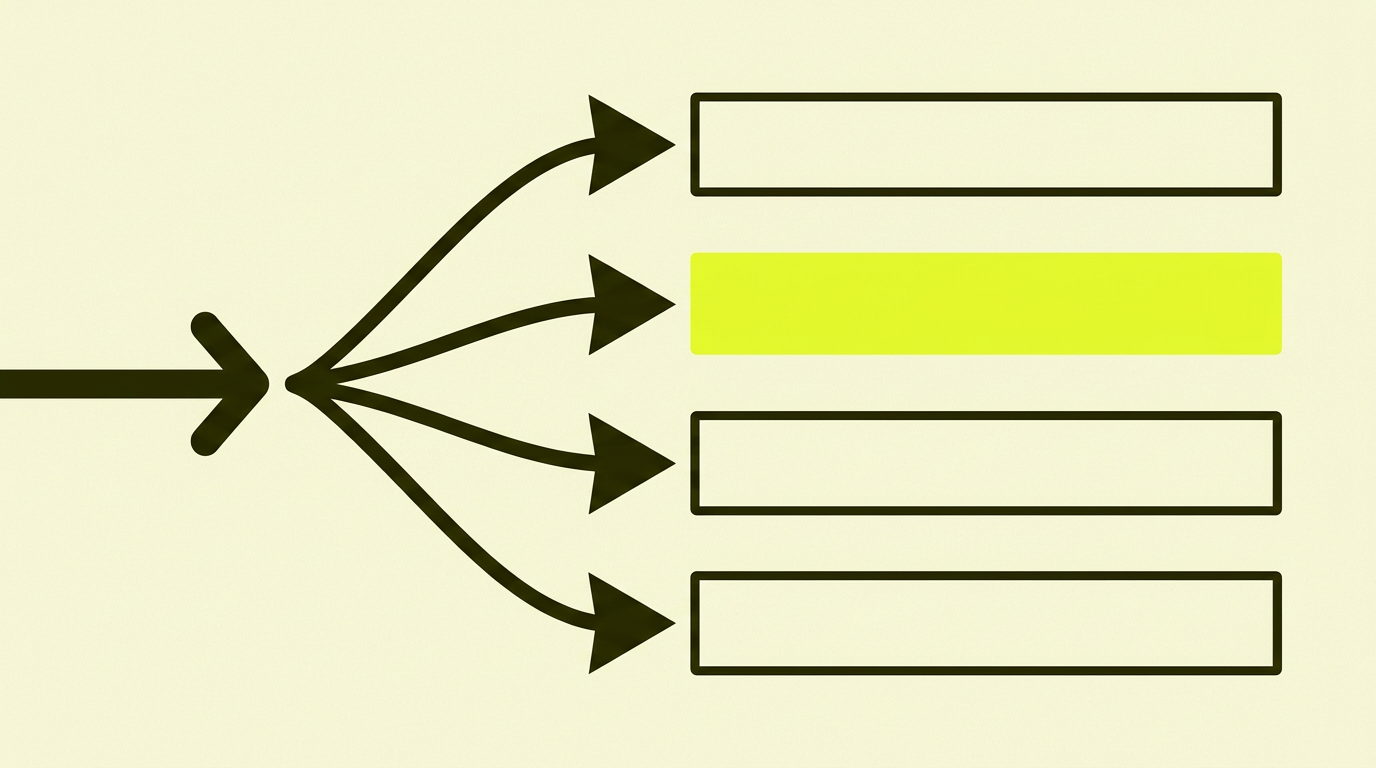
Så hva gjør modellene i stedet? Her må jeg være ærlig om at ingen leverandør har publisert den faktiske algoritmen. Men mønsteret i hva som faktisk blir sitert peker mot noen ting:
- Query fan-out. Spørsmålet ditt blir splittet i mange underspørsmål, og en side trenger ikke rangere høyt på hovedsøket, den trenger bare å vinne én av delspørringene.
- Semantisk matching på avsnittsnivå, ikke hele siden. Modellen ser etter presise svar i konkrete avsnitt, ikke etter hvilken side som har mest generell autoritet på Google.
- Konsensus på tvers av kilder. Påstander som gjentas og bekreftes flere steder vinner ofte over én enkelt «autoritativ» side.
- Struktur som filter. Klare overskrifter, ett poeng per avsnitt og direkte svar er rett og slett lettere for en modell å plukke opp og gjengi riktig.
Hver modell har sin egen greie
Det er heller ikke sånn at alle KI-modeller fungerer likt. De bygger nesten separate kildeøkosystemer.
- ChatGPT favoriserer Wikipedia.
- Perplexity favoriserer Reddit.
- Claude lener mot merkevareeide domener og er påfallende forsiktig med sosiale kilder.
Bare 13 prosent av domenene Claude siterer overlapper med det ChatGPT siterer.
Bruksmønsteret er også forskjellig.
- ChatGPT er mest generalist, brukt til alt fra praktiske råd til skriving.
- Gemini er sterkest der brukeren allerede er i Googles økosystem.
- Claude leder innen koding og er mest brukt i virksomheter, ikke av vanlige forbrukere.
- Perplexity brukes mest til kildekritisk research.
Ifølge Menlo Ventures' nyeste rapport har Anthropic nå 40 prosent av enterprise LLM-forbruket, mot OpenAIs 27 prosent. Verdt å nevne at Menlo selv er investor i Anthropic, men retningen bekreftes av uavhengige forbruksdata fra Ramp.
Det som ligger under mye av dette er en forskjell i hva folk faktisk bruker verktøyene til. Google er fortsatt sterkest når noen vet hva de vil ha og er klare til å handle.
KI-modeller brukes i økende grad til noe annet, en slags sparring før beslutningen tas i det hele tatt. «Jeg vurderer å bytte regnskapsfører, hva bør jeg tenke på» er et typisk KI-prompt som aldri ville blitt skrevet som et Google-søk. Det gir opphav til det Profound har kalt et "whitespace", emner med høyt volum av KI-spørsmål men lavt eller ingen tradisjonelt søkevolum, rett og slett fordi den typen etterspørsel aldri når Google i det hele tatt.
Det betyr at én generisk GEO-strategi ikke treffer noen av dem særlig godt.
Vi måler dette dårligere enn de fleste tror
Dette er kanskje det som overrasket meg mest da jeg gravde i det.
Når et menneske klikker på en lenke inne i et KI-generert svar, skal det i teorien dukke opp i Google Analytics. Google la til en egen "AI Assistant"-kanal i GA4 i mai 2026, som automatisk fanger opp besøk fra blant annet ChatGPT og Gemini.
Men Perplexity er ikke inkludert i den kanalen. Og mellom 35 og 70 prosent av all AI-referral-trafikk kommer uten noen referrer-informasjon i det hele tatt, og havner dermed i «Direct» i stedet.
Jeg går gjennom konkret hvordan du fanger opp mer av dette i del 5 av denne serien, om GA4-oppsett.
Og det er bare når et menneske klikker på noe. Når selve modellen søker og henter informasjon for å svare på et spørsmål, uten at et menneske klikker på noe som helst, dukker det ikke opp i Google Analytics i det hele tatt. Det vises som bot-trafikk i serverloggene dine, hvis du i det hele tatt ser etter det.
Og selv da vet du ikke om besøket faktisk ble til en sitering i et svar. Et bot-besøk i loggen din betyr bare at modellen så på siden din. Det er ingen garanti for at den brukte den til noe.
Det finnes en rekke verktøy som forsøker å måle faktisk synlighet i KI-svar, blant dem Profound, Peec AI, Otterly.ai, Ahrefs Brand Radar, Rankscale AI, AthenaHQ, Scrunch og seoClarity ArcAI.
Men kategorien er ung, og de aller fleste «beste verktøy»-listene der ute er skrevet av en leverandør som selv selger et slikt verktøy. Verdt å vite før du stoler blindt på noen av dem, og verdt å sjekke konkret hvilke motorer et verktøy faktisk dekker før du velger et. Jeg går grundigere gjennom styrker, svakheter og egne erfaringer med disse verktøyene i del 4 av denne serien.
Så hva gjør vi med dette, i Norge, i dag
For norsk forbrukerrettet synlighet er ChatGPT desidert høyeste prioritet akkurat nå. Tallene er ikke tvetydige på det punktet.
Men det betyr ikke at Google-fundamentet er mindre viktig. Mye av det Gemini gjør, spesielt via Google AI Overviews, blir ikke engang registrert som "KI-trafikk" i vanlig analytics, det blir bare telt som Google-søk. Så Googles reelle påvirkning er trolig større enn tallene isolert sett viser.
Og hvis kunden din er B2B eller teknisk, er Claude langt mer relevant enn forbrukertallene skulle tilsi. Det er ikke synlig i denne typen måling i det hele tatt, men det er der beslutningstakere faktisk er.
Det finnes ingen roadmap for "synlighet i KI", og det er greit å si høyt
Mange kunder spør meg nå om akkurat dette. Hvordan dukker vi opp i ChatGPT? Hvordan blir vi sitert av KI?
Det ærlige svaret er at det ikke finnes noe konkret svar på det spørsmålet i dag.
Ikke en roadmap for «synlighet i KI» generelt, og ikke engang en roadmap for «synlighet i ChatGPT» spesifikt. For mye er fortsatt ukjent.
En første retning, og trolig den viktigste, er å finne ut hvilke modeller målgruppen din faktisk bruker. Det avhenger av flere faktorer samtidig, blant annet hva de leter etter og hvor de befinner seg geografisk. Det er derfor Norge-tallene over er mer enn en kuriositet, de er en konkret start på akkurat det spørsmålet.
Vi vet også noe om hvordan de ulike modellene henter og siterer informasjon, det har jeg brukt mesteparten av denne artikkelen på. Men vi er langt fra å forstå nyansene godt nok til å garantere noe som helst.
- Behold teknisk SEO som fundamentet. Google-rangering er fortsatt det sterkeste enkeltsignalet på tvers av nesten alle KI-modeller, selv om det ikke lenger er tilstrekkelig alene. Dette er ikke noe man legger bak seg for å «satse på GEO» i stedet.
- Skriv for avsnittet, ikke bare for siden. Dette er blant de få GEO-observasjonene som faktisk har noe empirisk støtte. Siden modeller ofte henter presise svar fra enkeltavsnitt, ikke fra sidens totale autoritet, hjelper det at hvert avsnitt kan stå alene og svare på ett konkret spørsmål.
- Kjenn til at motorvalg avhenger av målgruppen din, ikke av deg. Intensjon og geografi avgjør mer enn noen generell «beste praksis». I Norge betyr det i praksis at ChatGPT er høyeste prioritet for forbrukerpublikum akkurat nå, mens Claude er mer relevant hvis kunden din er B2B eller teknisk.
Jeg har skrevet mer utfyllende om de konkrete GEO-grepene i artikkelen min om GEO, blant annet strukturert data, FAQ-formatering, entity-konsistens på tvers av kanaler og digitale PR-nevnelser. Den utdyper noen av punktene over i mer detalj, men samme forbehold gjelder der som her: dette er tiltak med noe belegg, ikke en garantert oppskrift.
Det jeg bevisst ikke gjør her er å love deg mer enn det. Ingen sporingsoppsett, verktøy eller innholdstriks endrer på at vi fortsatt vet for lite om hvordan disse modellene faktisk vekter det de finner.
Alt annet jeg har skrevet i denne artikkelen, om dobbel rangering, om måling i GA4, om hver modells kildeøkosystem, er bakgrunn for å forstå landskapet. Ikke en oppskrift for å vinne i det.
Og kanskje aller viktigst, det starter med å faktisk forstå hva disse verktøyene er og hvordan de fungerer. Ikke bare hvordan man bruker dem.
Det gjelder også Google selv, som fortsatt sender desidert mest trafikk av alle. I del 2 av denne serien går jeg gjennom hvordan Googles egen resultatside har endret seg med AI Overviews, og hva det konkret betyr for synlighet.